目标说话人模式的比较输入
目标链路 → 最终句段音频 → 对比模型 → 句段下方结果
使用目标说话人链路实际产出的音频,不重新录制整场或把非目标音频送给对比模型。角色模式和目标模式分别回归,避免模式切换后保留错误结果归属。
逐句比较模型结果的体验工作台
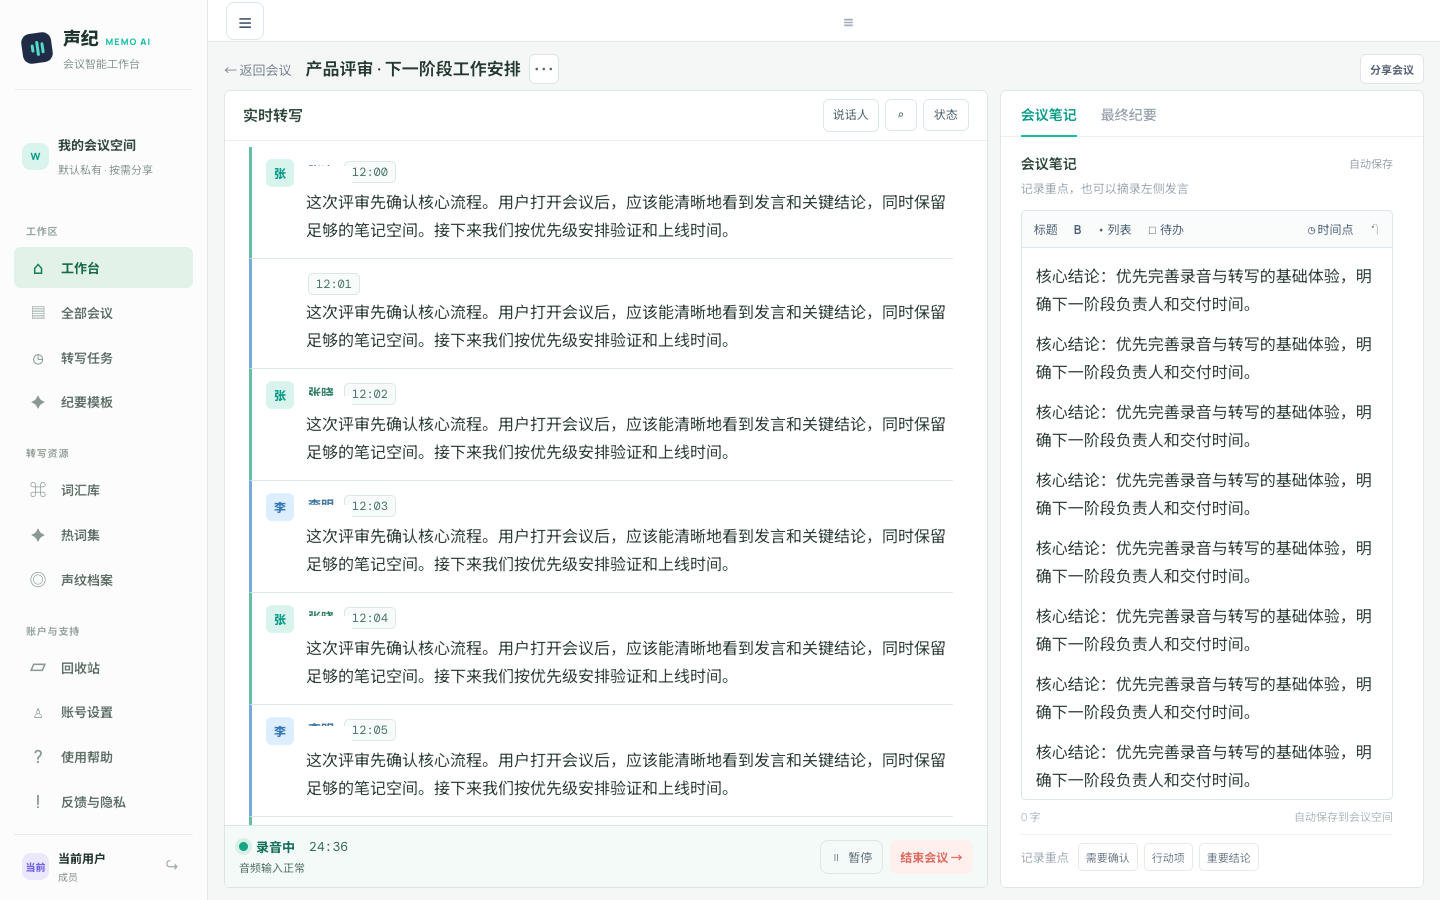
Playground 面向语音模型体验与接入调试,包含实时识别、会议角色和目标说话人页面。增加对比 Provider 时,输入音频、切分和角色条件需要保持可解释,否则界面并排显示的文字不能说明差异来自哪里。
页面将第三方识别放在主链路最终句段下方,复用对应音频范围。用户可关闭对比,主识别模式与协议保持既有行为;同一模式的角色结果、时间和对比文本在界面中关联。
选择模式、展示逐句结果并持久化对比开关。
确定业务句段、音频范围和主结果。
对同句段调用真实识别接口,将结果追加到主文本下方。
目标链路 → 最终句段音频 → 对比模型 → 句段下方结果
使用目标说话人链路实际产出的音频,不重新录制整场或把非目标音频送给对比模型。角色模式和目标模式分别回归,避免模式切换后保留错误结果归属。
主结果独立返回;可选对比 → 独立状态与追加文本
对比默认关闭,启用后作为逐句附加内容。主识别的角色、终态和文本保持既有协议,第三方输出以独立来源呈现。
不同模型自行断句时,结果的数量和范围并不相同;拿两段看起来相似的文字比较会掩盖输入差异。
主链路先确定最终句段,再复用该段音频调用对比 Provider。页面按句段关联结果,角色和目标模式分别限定音频来源。
用户可以沿同一段语音查看差异,界面比较仍不替代有标注数据的准确率评测。
增加第三方模型容易把新的失败和延迟引入既有识别路径。
对比是可选附加能力,关闭时保留原协议和主页面行为;开关在实时页和会议页共享,刷新后仍可恢复选择。
新 Provider 的接入成本集中在适配与结果展示,不要求用户换一套识别工作台。
使用最终句段范围,而不是对齐两份独立断句文字。
两种模式分别检查对比结果归属与界面呈现。
对比开关与主识别状态分开。